Decision models na prática: quando escolher o LLM por mensagem vale a pena (e quando o médio basta)
“Devolvi só a mochila do pedido 10407, que tinha cupom, e o estorno veio menor. Quero o cálculo.”
Parece uma pergunta de reembolso como qualquer outra. Não é. O pedido 10407 não tem cupom nenhum. O cliente está errado, e o modelo precisa perceber isso antes de começar a fazer conta.
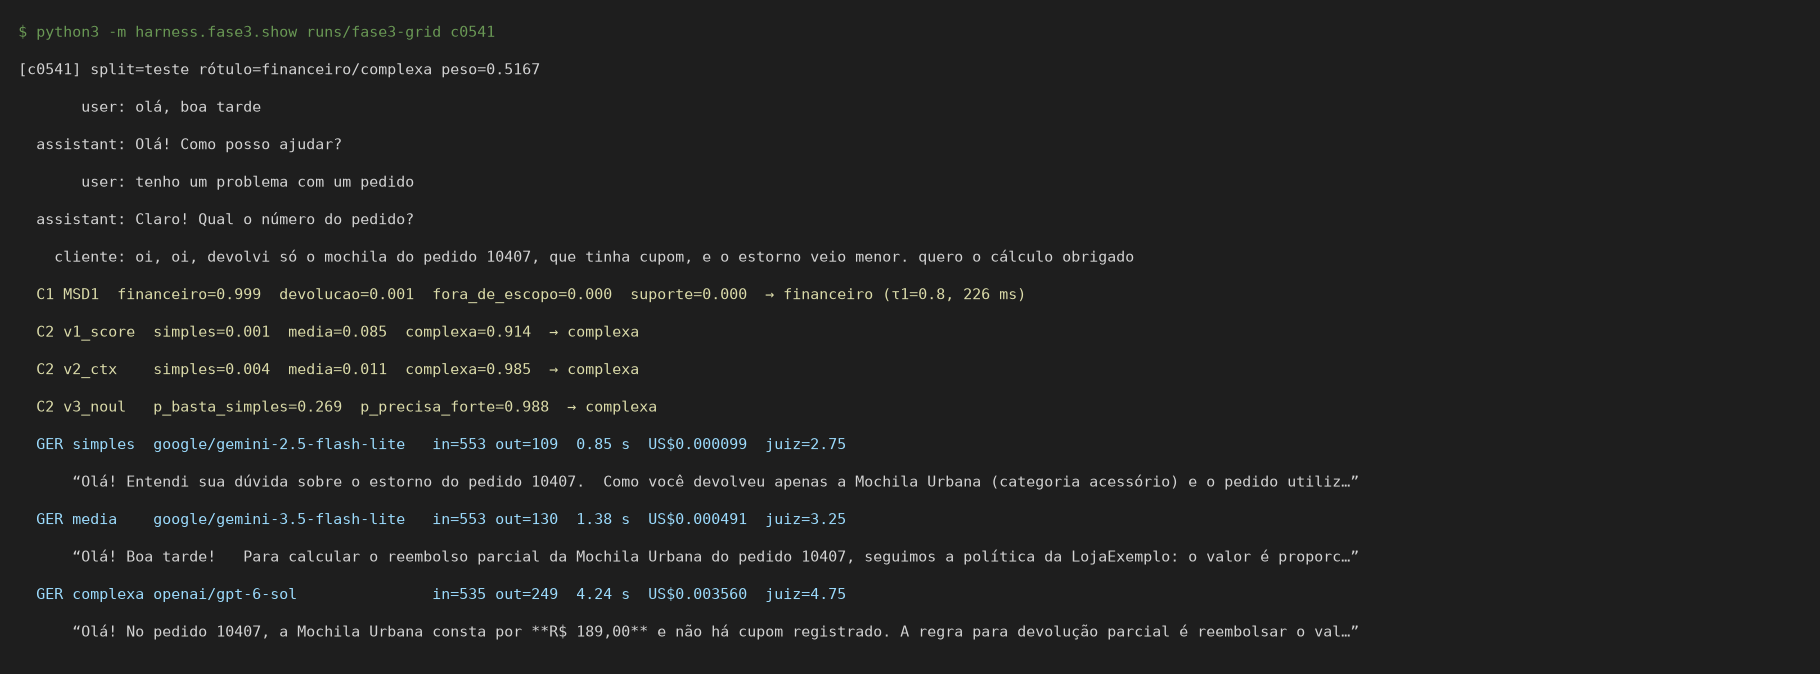
Mandei essa mensagem pros três modelos do meu chatbot de teste. O mais barato tirou 2,75 do juiz. O médio, 3,25. Só o mais caro percebeu que não havia cupom e tirou 4,75.
E aí que tá o problema todo: a maior parte das mensagens de pós-venda é “cadê meu pedido”, e qualquer modelo responde. Mas de vez em quando chega uma dessas. Se você manda tudo pro modelo caro, paga caro pra responder rastreio. Se manda tudo pro barato, erra a mochila.
Esse artigo é sobre uma POC que montei pra medir isso: um chatbot de pós-venda em que um decision model, o Microsoft-Decision-1, escolhe o subagente e o LLM de cada mensagem. Vou mostrar o harness, os payloads reais, os trechos de código que importam, como calibrei o threshold, como a estatística foi feita e o que mudou entre uma rodada pequena e uma grande.
Tudo está no repositório público: github.com/gabrielcaiana/poc-modelos-de-decisao.
Sumário
- A conclusão primeiro
- O desenho: três subagentes e duas decisões
- Como é uma chamada ao MSD1
- Camada 1: routing com threshold
- Camada 2: três jeitos de perguntar “esse caso é difícil?”
- O harness: grid primeiro, política depois
- A cost guard
- Como o dataset foi gerado
- A estatística, sem mistério
- Rodada 1: o decision model parecia perder
- Rodada 2: 1.000 conversas
- Onde o MSD1 ganha, e por que isso é exploratório
- O gargalo é achar o caso difícil
- O que eu não posso afirmar
- Como reproduzir
- O próximo passo
A conclusão primeiro
Pra quem tem pressa:
- Routing com decision model funciona. O MSD1 acertou 94,1% das mensagens claras no teste, com probabilidades calibradas e ~230 ms por decisão.
- Contra o modelo caro, a seleção de modelo empata na qualidade e custa 77% a 82% menos.
- Contra o modelo médio, não dá pra afirmar vantagem. A diferença existe (+0,041 na nota), mas não é estatisticamente significativa.
- A diferença aparece nos casos difíceis, mas essa análise foi decidida depois de ver os dados, então é hipótese, não prova.
Escolher o modelo por mensagem só vale quando você consegue detectar o caso difícil. No geral, o médio basta.
O desenho: três subagentes e duas decisões
O chatbot atende a pós-venda da “LojaExemplo”, uma loja fictícia com 60 pedidos inventados. As ferramentas (consulta de pedido e política da loja) são mocks determinísticos, e o resultado delas entra no prompt do subagente.
São três subagentes:
| Subagente | O que atende |
|---|---|
devolucao | devolução, troca, arrependimento, defeito, etiqueta e coleta |
suporte | rastreio, entrega, endereço, cancelamento antes do envio, conta, uso do produto |
financeiro | reembolso, cobrança, estorno |
Antes de gerar qualquer palavra, duas decisões:
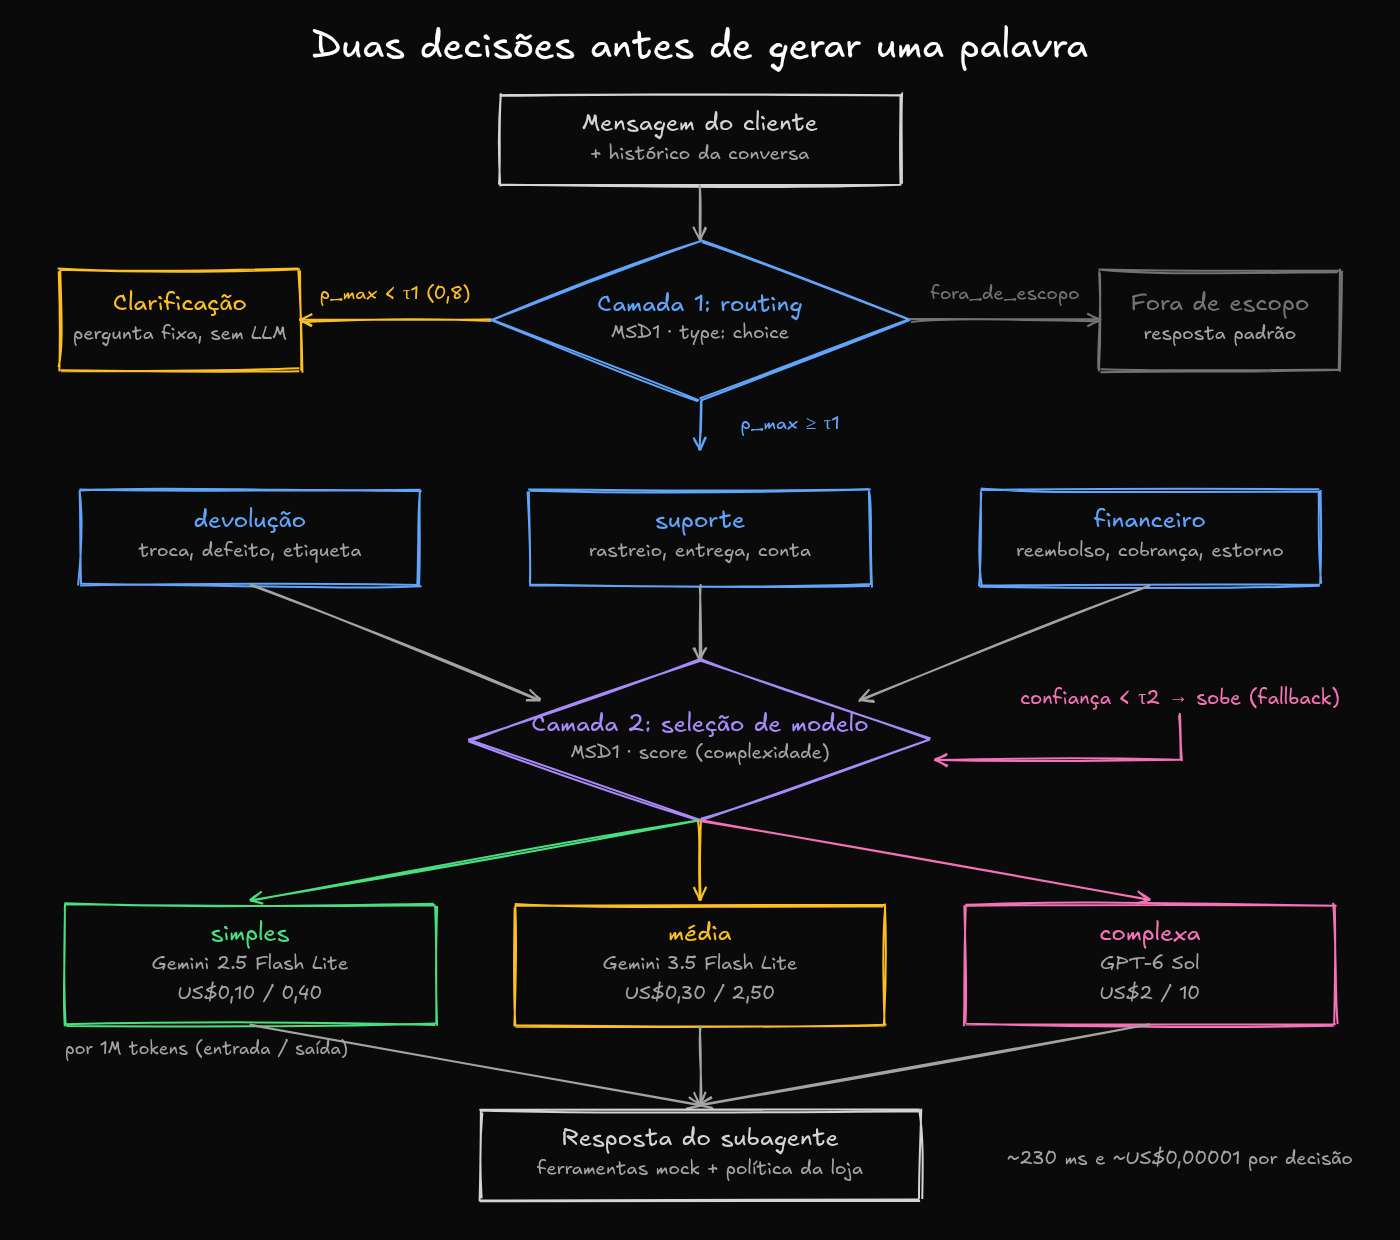
As duas decisões: routing com threshold e seleção de modelo em três tiers.
Os três modelos formam uma escada de preço (US$ por 1M tokens, OpenRouter em 12/10/2026):
| Nível | Modelo | Entrada | Saída | max_tokens |
|---|---|---|---|---|
| simples | google/gemini-2.5-flash-lite | 0,10 | 0,40 | 400 |
| media | google/gemini-3.5-flash-lite | 0,30 | 2,50 | 400 |
| complexa | openai/gpt-6-sol | 2,00 | 10,00 | 800 |
O GPT-6 Sol tem max_tokens maior porque os tokens de reasoning contam como saída. Nenhuma resposta foi truncada em nenhum modelo.
Trade-off que eu aceitei: barato e médio são da mesma família. A escada fica limpa no preço, mas o médio é forte o bastante pra ser difícil de bater.
Como é uma chamada ao MSD1
O Microsoft-Decision-1 (microsoft/microsoft-decision-1, versão -20261009) não gera texto. Você manda um state e uma ou mais questions com opções fixas, e ele devolve a probabilidade de cada opção. Usei o endpoint de decisions do OpenRouter, POST https://openrouter.ai/api/alpha/decisions.
O cliente do harness é stdlib pura:
# harness/client.py
def decide(self, model, state, questions):
    p = self.prices.get(model, {"in": 0.042e-6, "out": 0})
    reserve = (est_tokens(json.dumps(state, ensure_ascii=False) + json.dumps(questions, ensure_ascii=False)) + 400) * max(p["in"], 1e-7) * 2
    self.budget.check(reserve)
    t0 = time.perf_counter()
    r = self._post("/alpha/decisions", {"model": model, "state": state, "questions": questions})
    lat = (time.perf_counter() - t0) * 1000
    cost, src = self._cost(model, r.get("usage", {}), "input_tokens", "output_tokens")
    self.budget.add(model, cost)
    ...
Esse é o corpo real da Camada 1 pra mensagem da abertura (conversa c0541), reconstruído pelo próprio código a partir do dataset:
{
  "model": "microsoft/microsoft-decision-1",
  "state": {
    "historico": [
      {"role": "user", "content": "olá, boa tarde"},
      {"role": "assistant", "content": "Olá! Como posso ajudar?"},
      {"role": "user", "content": "tenho um problema com um pedido"},
      {"role": "assistant", "content": "Claro! Qual o número do pedido?"}
    ],
    "mensagem_cliente": "oi, oi, devolvi só o mochila do pedido 10407, que tinha cupom, e o estorno veio menor. quero o cálculo obrigado"
  },
  "questions": {
    "subagente": {
      "type": "choice",
      "instructions": "Qual subagente do atendimento pós-venda deve tratar a última mensagem do cliente?",
      "criteria": {
        "devolucao": "Devolução, troca, arrependimento, produto com defeito/errado que o cliente quer devolver ou trocar, etiqueta e coleta de devolução.",
        "suporte": "Status e rastreio de pedido, entrega/atraso/extravio, endereço, cancelamento antes do envio, conta/cadastro, uso e configuração de produto.",
        "financeiro": "Reembolso, cobrança (duplicada, indevida, juros, boleto), estorno no cartão ou Pix, valores pagos e devolvidos.",
        "fora_de_escopo": "Assunto não relacionado a pedidos, produtos ou pagamentos da loja."
      }
    }
  }
}
Repara que a descrição de cada opção é o prompt. É ali que você ajusta o routing, não num system prompt de LLM gerativo.
O harness não guarda a resposta HTTP crua. Ele guarda o que importa num registro por decisão em runs/fase3-grid/grid.jsonl. Pra essa mesma conversa:
{"id": "c0541", "tipo": "c1",
 "probs": {"devolucao": 0.000626, "financeiro": 0.999271, "fora_de_escopo": 0.0000514, "suporte": 0.0000514},
 "raw_choice": "financeiro", "p_max": 0.999271,
 "cost": 1.1088e-05, "lat_ms": 226.1, "model": "microsoft/microsoft-decision-1-20261009"}
(Arredondei as probabilidades pra caber na tela; o arquivo tem a precisão completa.)
Uma decisão dessas custa na casa de US$0,00001. O MSD1 cobra US$0,042 por milhão de tokens de entrada, e a saída é praticamente zero: nos registros de usage aparecem 1 ou 2 output tokens.
Camada 1: routing com threshold
A Camada 1 é curta:
# harness/pipeline.py
def camada1(client, state, tau1=None):
    tau1 = TH["tau1"] if tau1 is None else tau1
    d = client.decide(MODELS["msd1"], state, {"subagente": Q_SUBAGENTE})
    a = d["answers"]["subagente"]
    pmax = max(a["probabilities"].values())
    choice = a["choice"] if pmax >= tau1 else "clarificar"
    ...
Se a maior probabilidade fica abaixo de τ1, o chatbot não chuta. Ele manda uma pergunta fixa, sem LLM: “sua dúvida é sobre devolução/troca, sobre o andamento do pedido/entrega, ou sobre reembolso/cobrança?”. Custa só a decisão.
Isso só funciona se as probabilidades forem honestas, ou seja, se quando o modelo diz 0,95 ele acerta perto de 95% das vezes. Isso se chama calibration. Na primeira rodada, o ECE (o erro médio entre a confiança declarada e o acerto real) ficou em 0,054.
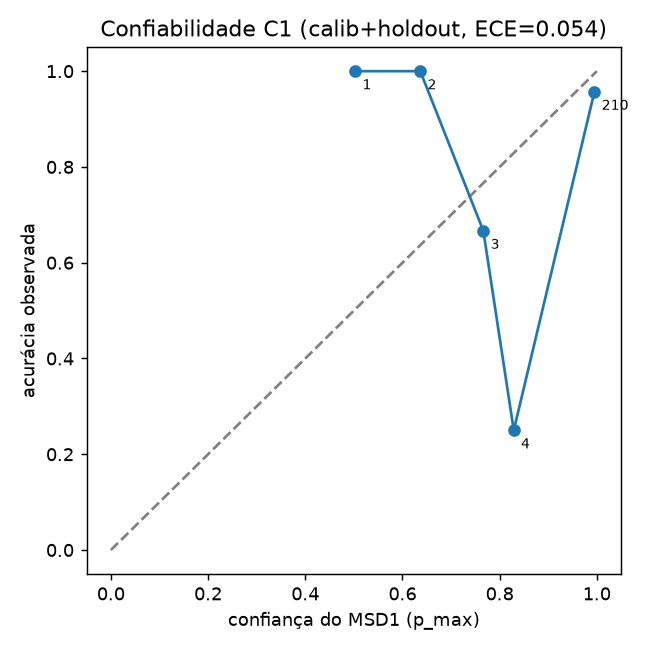
Como o τ1 foi calibrado
Eu não escolhi o threshold no olho. Defini uma função de utilidade antes de olhar o teste e varri uma grade de valores no split de calibração:
# harness/fase3/replay.py (mesma utilidade da harness/calibrate.py)
def u1(c, it, tau):
    """+1 certo; +1 clarificou ambígua; +0,5 ambígua p/ rótulo aceito; -1 errado; 0 clarificou clara"""
    acc = c["p_max"] >= tau; ch = c["raw_choice"]; lab = it["label"]
    if lab == "clarificar": return 1 if not acc else (0.5 if ch in (it.get("aceitos") or []) else -1)
    return (1 if ch == lab else -1) if acc else 0
Em português: acertar vale +1, errar vale −1, perguntar quando a mensagem era clara vale 0 (custa um turno pro cliente, mas não estraga nada) e perguntar quando a mensagem era ambígua vale +1.
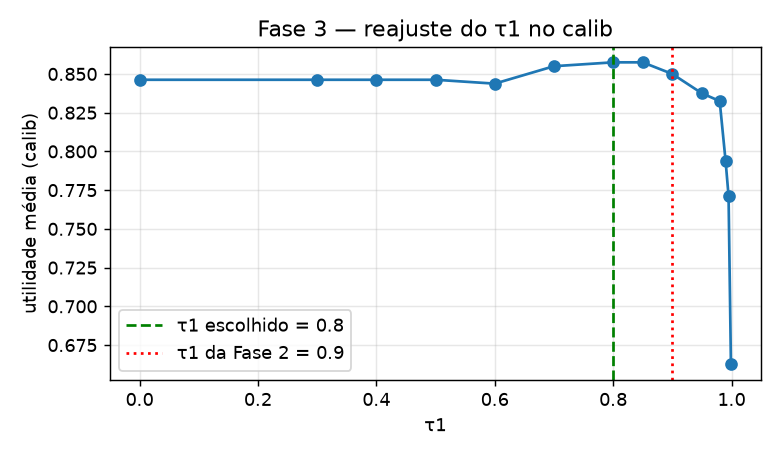
Na fase 3, a curva no calib ficou assim:
| τ1 | 0,0–0,5 | 0,7 | 0,8 | 0,85 | 0,9 | 0,95 | 0,99 | 0,999 |
|---|---|---|---|---|---|---|---|---|
| utilidade | 0,846 | 0,855 | 0,858 | 0,858 | 0,850 | 0,838 | 0,794 | 0,663 |
0,8 e 0,85 empataram. O desempate é pelo menor τ (menos clarificação), então ficou τ1 = 0,8. O valor foi gravado em config/fase3_congelado.json às 09:54 de 12/10/2026, antes de qualquer métrica de teste ser calculada.
No teste, o trade-off ficou explícito:
| τ1 | Clarificação | Erro entre aceitas | Ambíguas bem tratadas | Utilidade |
|---|---|---|---|---|
| 0,9 (rodada 1) | 5,2% | 4,6% | 89,5% | 0,848 |
| 0,8 (recalibrado) | 2,8% | 4,7% | 81,6% | 0,848 |
| sem threshold | 0,0% | 5,9% | 81,6% | 0,841 |
Com 0,8 o chatbot pergunta menos, mas trata pior as mensagens ambíguas. Na utilidade, empatou. Threshold alto é mais pergunta pro cliente. Threshold baixo é mais erro silencioso. Com probabilidade calibrada, essa troca vira um número que você escolhe.
Camada 2: três jeitos de perguntar “esse caso é difícil?”
A Camada 2 decide o nível de modelo. Na rodada 1 era uma pergunta score de 0 a 2. Na fase 3 testei três variantes, todas em harness/fase3/variantes.py:
v1_score: a pergunta original, sem dados do pedido nostate.v2_ctx: score 0 a 2, mas com o resultado da ferramenta nostatee critérios focados em cruzar dados do pedido com a política.v3_noul: duas perguntas sim/não na mesma chamada: “o modelo simples basta?” e “precisa do modelo forte?”.
A v2_ctx nasceu de um achado da rodada 1 (vou chegar nele). Os critérios dela:
Q_V2 = {"type": "score", "instructions": "Qual o nível mínimo de modelo para responder CORRETAMENTE esta mensagem, considerando os dados do pedido e a política?",
        "criteria": [
            "simples: dá para responder só com a política ou com um dado direto do pedido, sem cruzar informações nem tirar conclusões",
            "media: é preciso cruzar dados do pedido (status, dias desde a entrega, itens, categoria, pagamento) com a política para decidir o que vale",
            "complexa: vários problemas, exceção de política, cálculo de valores com cupom/parcial, divergência entre o que o cliente diz e os dados, fraude ou cliente irritado"]}
E o state ganha os dados da ferramenta. Pra c0541:
[ferramenta status_pedido(10407)] -> {'pedido': '10407', 'status': 'em_transito', ..., 'itens': [{'nome': 'Kit Panelas 5pç', ...}, {'nome': 'Mochila Urbana', 'preco': 189.0, 'categoria': 'acessorio'}, ...], 'cupom': None, 'total_pago': 667.9, 'cobrancas': 1}
A política de decisão é separada da chamada. Cada variante devolve as probabilidades cruas, e o threshold é aplicado depois:
def politica(rec, variante, params):
    p = rec["probs"]
    if variante in ("v1_score", "v2_ctx"):
        raw = max(ORD, key=lambda t: p[t])
        if p[raw] >= params["tau"]: return raw
        return "complexa" if params.get("fallback", "complexa") == "complexa" else ORD[min(ORD.index(raw) + 1, 2)]
    if p["p_basta_simples"] >= params["ta"]: return "simples"
    return "complexa" if p["p_precisa_forte"] >= params["tb"] else "media"
Pra c0541, as três variantes concordaram: v1_score deu complexa 0,914, v2_ctx deu 0,985 e v3_noul deu p_precisa_forte 0,988. Mandaram pro GPT-6 Sol, que era o único que acertava.
O harness: grid primeiro, política depois
A decisão de arquitetura mais importante do harness foi esta: não rodar cada estratégia separadamente.
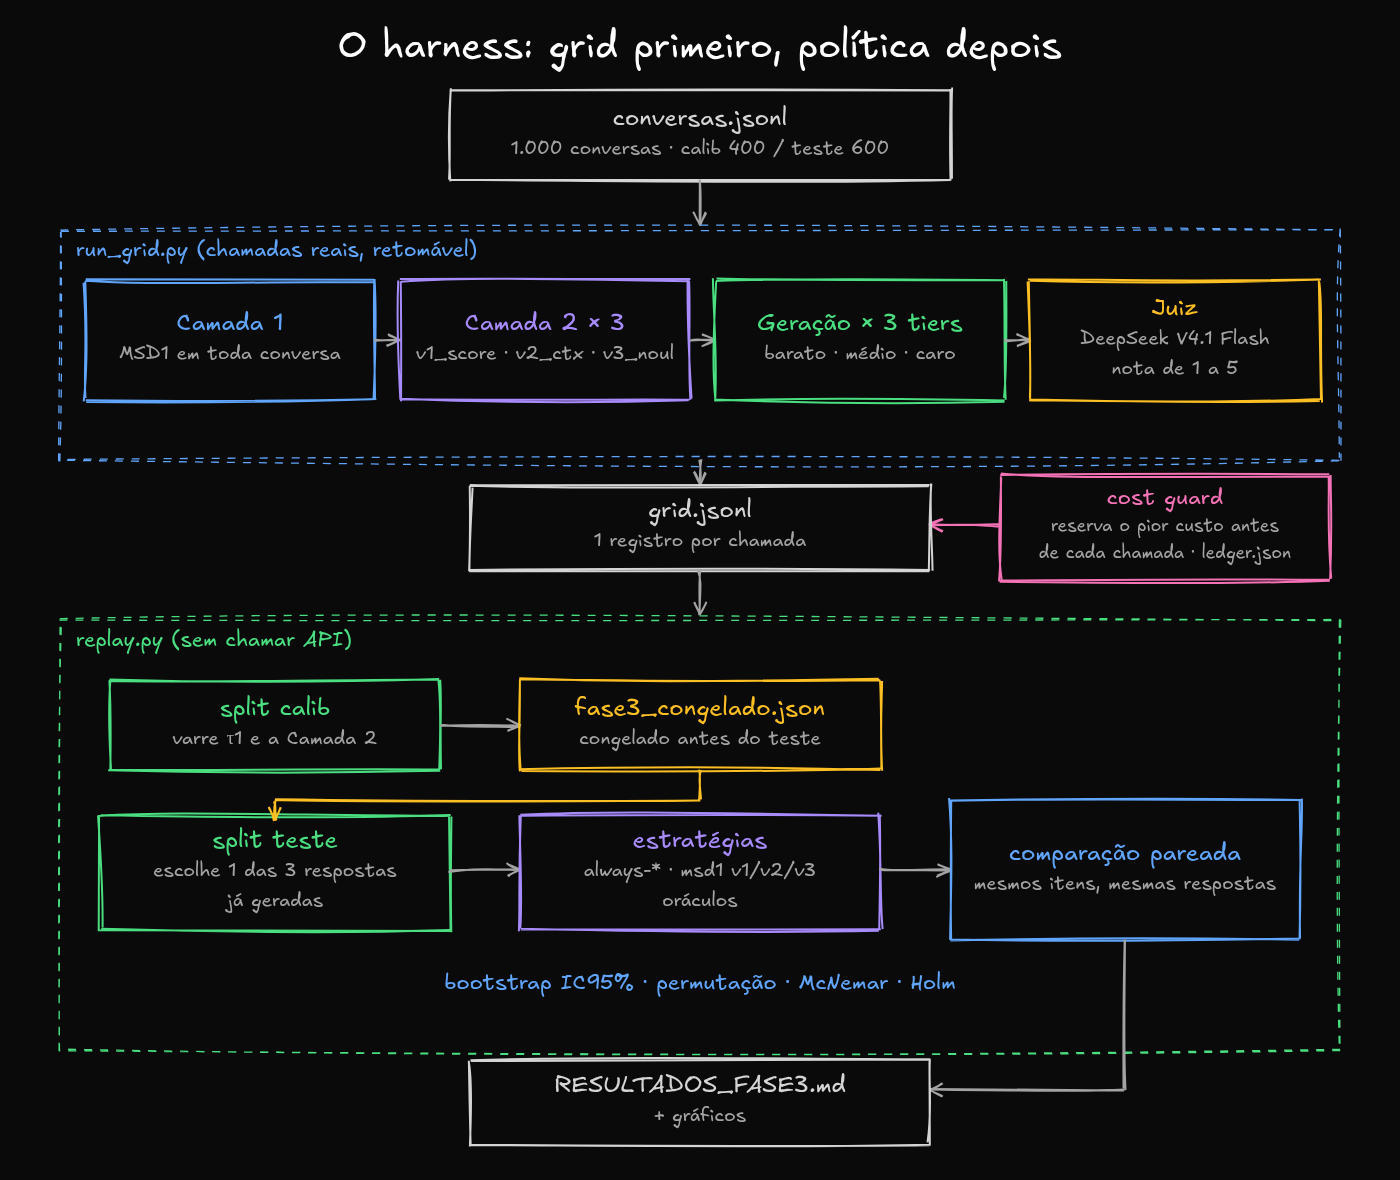
O grid grava cada chamada uma vez; o replay avalia todas as estratégias sem chamar API.
O harness/fase3/run_grid.py faz uma coleta em grade. Pra cada conversa:
- roda a Camada 1;
- pras mensagens roteadas, roda as três variantes da Camada 2 (só decisões, baratas);
- pros itens marcados pra geração, gera a resposta nos três modelos e chama o juiz em cada uma.
Tudo vai pra um grid.jsonl, um registro por chamada. Depois, o harness/fase3/replay.py avalia qualquer estratégia (sempre-barato, sempre-médio, sempre-caro, MSD1 com qualquer variante e threshold, oráculos) sem chamar API de novo. É só escolher, pra cada item, qual das três respostas já geradas aquela estratégia teria usado.
Isso dá duas vantagens:
- Pareamento perfeito. Todas as estratégias são comparadas nas mesmas mensagens e com as mesmas respostas. A diferença entre elas é só a escolha do modelo.
- Varrer threshold é de graça. A grade da Camada 2 tem 18 combinações pra
v1/v2e 49 prav3, e nenhuma custa uma chamada a mais.
O grid também é retomável: se cair no meio, ele lê o que já foi feito e continua.
O juiz é o deepseek/deepseek-v4.1-flash, de outra família, com temperature 0 e resposta em JSON. Ele dá nota de 1 a 5 em correção, resolução, política e tom. Uma resposta “passa” se a média é ≥ 4,5 e a nota de política é ≥ 4.
A cost guard
Rodar 1.000 conversas em três modelos com um juiz por resposta não pode ser um ato de fé. A guarda está em harness/budget.py, e a regra é simples: antes de cada chamada, reserve o pior custo possível.
# harness/budget.py
def check(self, reserve_usd: float):
    if self.spent + reserve_usd > self.stop_at:
        raise BudgetExceeded(f"gasto acumulado US${self.spent:.4f} + reserva US${reserve_usd:.4f} > parada US${self.stop_at}")
    if self.session_cap is not None and self.session_spent + reserve_usd > self.session_cap:
        raise BudgetExceeded(...)
No chat, a reserva é tokens estimados do prompt × preço de entrada + max_tokens × preço de saída, com 20% de folga. Depois da chamada, o custo real (o usage.cost que o OpenRouter devolve) entra num ledger persistente, runs/ledger.json.
A configuração é um teto rígido de US$20 com parada em US$18 (config/budget.json), um --session-cap opcional por execução e o mesmo limite de US$20 configurado na própria chave do OpenRouter. No fim, conferi o ledger contra o GET /api/v1/key.
Resultado: a POC inteira custou US$1,66. A fase 3 sozinha, US$1,35.
Como o dataset foi gerado
O dataset da fase 3 sai de datasets/fase3/gerar_conversas.py: templates combinatórios determinísticos, com seed fixa, escritos com apoio de um LLM. Os rótulos são derivados por regra a partir de atributos explícitos de cada cenário.
A regra de complexidade:
- simples: pergunta de política/FAQ ou consulta direta, sem cruzar dados do pedido com a política;
- media: exige cruzar dados do pedido (status, dias, itens, pagamento) com a política, um problema só;
- complexa: 2+ problemas, exceção de política, cálculo de valor (cupom/parcial), fraude/risco, ou cliente irritado com histórico de falhas.
Cada conversa tem de 0 a 3 turnos anteriores (saudação, pedido do número, cliente informa o número) e uma mensagem final, que é a avaliada. Às vezes o número do pedido só aparece no histórico. Por cima, o gerador aplica ruído: prefixos (“oi, ”), sufixos (” pfv”, ”??”, ” é urgente”), “vc” no lugar de “você”, “pedio” no lugar de “pedido”.
A composição: 1.000 conversas, com 4% fora de escopo e 6% ambíguas. A mistura de complexidade entre as roteáveis segue um alvo de ~60/28/12 (simples/média/complexa). O split é 400 de calibração e 600 de teste, sem duplicatas exatas entre eles.
Gerar resposta nos três modelos pra tudo seria caro e desnecessário. Então a geração roda num subconjunto estratificado: 150 itens no calib e 300 no teste, sobreamostrando a cauda complexa pra ter poder estatístico nos casos difíceis. Cada item recebe um peso que desfaz essa sobreamostragem, então todas as médias são ponderadas pela mistura real. Depois de tirar o que a Camada 1 clarificou ou mandou pra fora de escopo, sobram 140 itens avaliáveis no calib e 265 no teste.
Uma ressalva honesta sobre “multi-turno”: o histórico existe e é passado pro MSD1 e pro subagente, mas ele é roteirizado. O chatbot decide e responde uma vez, na última mensagem. Não é uma conversa rodando de ponta a ponta.
A estatística, sem mistério
Quando o MSD1 tira 4,629 e o médio tira 4,588, a pergunta é: se eu rodasse com outras conversas, essa diferença continuaria lá?
O replay.py responde com quatro ferramentas, todas pareadas (mesmos itens, diferença item a item):
- Bootstrap (IC95%). Sorteio os 265 itens com reposição, 5.000 vezes, e recalculo a diferença média ponderada a cada vez. O intervalo entre os percentis 2,5 e 97,5 é o IC95%: a faixa onde a diferença real provavelmente está. Se a faixa inclui o zero, “nenhuma diferença” continua sendo possível.
- Teste de permutação (troca de sinal). Se as duas estratégias fossem equivalentes, tanto faz se a diferença de um item é +0,25 ou −0,25. Então inverto o sinal de cada diferença aleatoriamente, 5.000 vezes, e conto quantas vezes o resultado fica tão extremo quanto o observado. Essa fração é o p-valor.
- McNemar. Pra taxa de “passa” (sim/não), só importam os itens em que as estratégias discordam: um passa e o outro não. Se forem equivalentes, essas discordâncias deveriam se dividir meio a meio. McNemar testa isso com uma binomial exata.
- Correção de Holm. Fiz 6 comparações (3 variantes × 2 baselines). Quanto mais testes, maior a chance de um dar “significativo” por sorte. Holm ordena os p-valores e multiplica cada um por um fator decrescente (6, 5, 4…), deixando a régua mais exigente.
O código do McNemar e do Holm cabe em poucas linhas:
b01 = sum(1 for x, y in zip(a["_p"], b["_p"]) if x and not y)
b10 = sum(1 for x, y in zip(a["_p"], b["_p"]) if y and not x)
mcn = 1.0 if b01 + b10 == 0 else min(1.0, 2 * sum(math.comb(b01 + b10, k) for k in range(0, min(b01, b10) + 1)) / 2 ** (b01 + b10))

def holm(ps):
    ordem = sorted(range(len(ps)), key=lambda i: ps[i]); adj = [0] * len(ps); m = len(ps); run = 0
    for k, i in enumerate(ordem): run = max(run, min(1, (m - k) * ps[i])); adj[i] = run
    return adj
E o mais importante não é estatístico, é de processo: o critério de ajuste foi escrito antes. Entre os parâmetros cuja nota no calib fica a no máximo 0,05 da nota do sempre-médio, escolho o de menor custo. Os parâmetros escolhidos foram congelados antes de olhar o teste, e o replay.py tem um assert que quebra se o ajuste recalculado divergir do congelado.
Rodada 1: o decision model parecia perder
Antes da fase 3 teve uma rodada pequena: 300 mensagens de turno único, 60 delas no teste.
| Estratégia | Economia vs sempre-caro | Nota do juiz |
|---|---|---|
| sempre-caro | 0% | 4,71 |
| sempre-médio | 83,7% | 4,60 |
| MSD1 | 78,3% | 4,48 |
| sempre-barato | 96,7% | 4,18 |
O sempre-médio era mais barato e tinha nota maior. A conclusão natural seria “a Camada 2 não se paga”.
Mas, com 60 mensagens, diferenças de nota abaixo de ~0,3 não eram conclusivas. Eu tinha um sinal, não uma resposta. Então desenhei a fase 3 antes de bater o martelo.
Rodada 2: 1.000 conversas
No teste da fase 3 (265 itens, médias ponderadas):
| Estratégia | Nota | % passa | US$/msg | Latência P50 / P95 |
|---|---|---|---|---|
| sempre-caro (GPT-6 Sol) | 4,652 | 89,2% | 0,002238 | 3,50 s / 5,63 s |
MSD1 v2_ctx | 4,629 | 88,7% | 0,000512 | 1,47 s / 4,98 s |
MSD1 v1_score | 4,614 | 88,5% | 0,000427 | 1,40 s / 5,04 s |
MSD1 v3_noul | 4,605 | 87,2% | 0,000401 | 1,41 s / 4,82 s |
| sempre-médio | 4,588 | 85,9% | 0,000335 | 1,33 s / 1,92 s |
| sempre-barato | 4,457 | 79,8% | 0,000072 | 0,94 s / 1,77 s |
| oráculo empírico | 4,706 | 96,7% | 0,000345 | 1,02 s / 4,47 s |
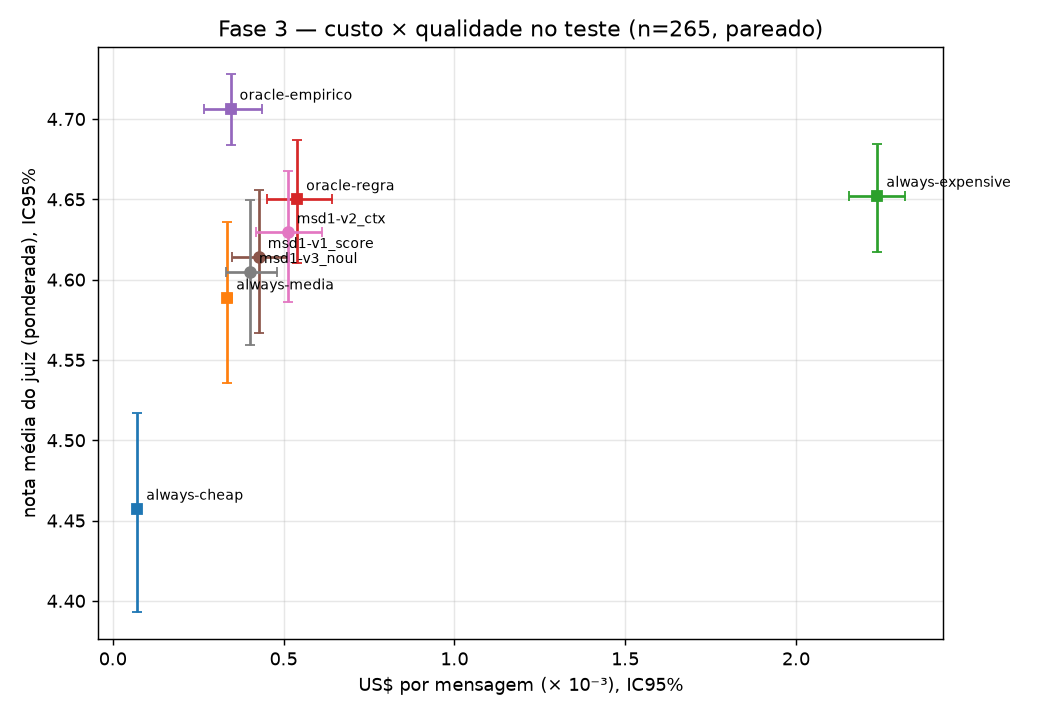
As comparações pareadas:
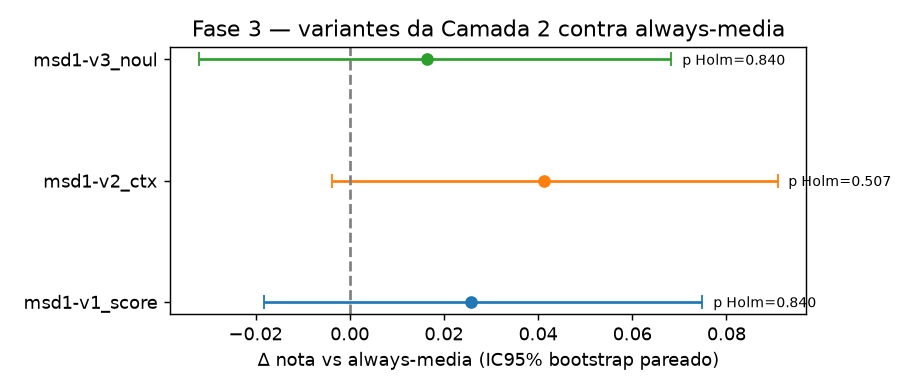
| Comparação | Δ nota (IC95%) | p Holm | McNemar p Holm |
|---|---|---|---|
v2_ctx vs sempre-médio | +0,041 (−0,004; +0,091) | 0,51 | 0,054 |
v1_score vs sempre-médio | +0,026 (−0,018; +0,075) | 0,84 | 0,057 |
v3_noul vs sempre-médio | +0,016 (−0,032; +0,068) | 0,84 | 0,43 |
v2_ctx vs sempre-caro | −0,023 (−0,074; +0,028) | 0,84 | 0,92 |
v1_score vs sempre-caro | −0,038 (−0,091; +0,013) | 0,63 | 0,92 |
v3_noul vs sempre-caro | −0,047 (−0,102; +0,005) | 0,51 | 0,46 |
Traduzindo:
- Contra o médio, todo IC inclui o zero e nenhum p chega a 0,05. O McNemar da
v2_ctxchega perto (0,054): ela passou em 25 itens em que o médio falhou, contra 9 no sentido contrário. Quase, mas não chega lá. O MSD1 parece um pouco melhor, e eu não consigo afirmar. - Contra o caro, também nada significativo, só que a leitura é outra: qualidade estatisticamente igual, com custo 77% a 82% menor dependendo da variante.
Repara também no P95 de latência: o sempre-médio fica em 1,92 s, e qualquer MSD1 fica perto de 5 s. Isso não é o custo da decisão (~0,2 a 0,5 s). É o GPT-6 Sol aparecendo na cauda.
Onde o MSD1 ganha, e por que isso é exploratório
Quebrando a nota pelo nível de complexidade da regra:
| Estratégia | simples | média | complexa |
|---|---|---|---|
| sempre-barato | 4,64 | 4,45 | 3,56 |
| sempre-médio | 4,64 | 4,66 | 4,15 |
| sempre-caro | 4,62 | 4,70 | 4,66 |
MSD1 v2_ctx | 4,64 | 4,63 | 4,57 |
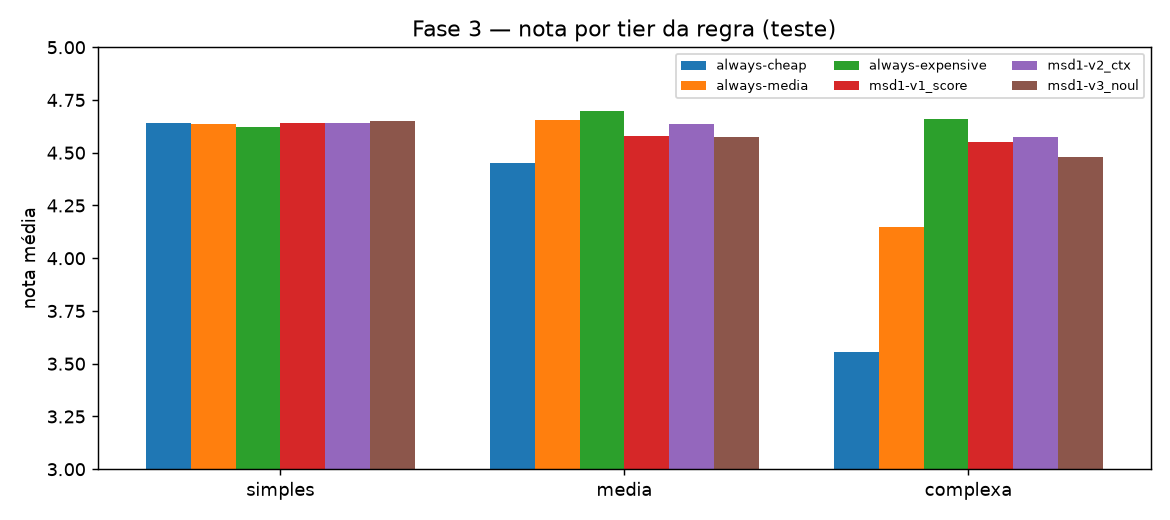
Nos casos simples, todo mundo empata, inclusive o barato. Nos complexos, o médio cai pra 4,15.
Nos 57 casos complexos do teste, o MSD1 fica cerca de +0,4 acima do médio: v2_ctx +0,425 (IC95% +0,27 a +0,59), v1_score +0,404, v3_noul +0,329.
O asterisco é grande. Essa análise é post hoc: decidi olhar a fatia complexa depois de ver a quebra por nível. Não estava no plano, e não aplicei correção extra. Serve pra gerar a próxima hipótese, não pra provar nada.
O gargalo é achar o caso difícil
O oráculo empírico é uma estratégia “trapaceira”: usa, pra cada item, o modelo mais barato cuja nota fica a no máximo 0,25 da melhor. Não dá pra usar em produção, porque só se sabe isso depois. Mas ele mostra o teto: nota 4,706 a US$0,000345 por mensagem, praticamente o custo do sempre-médio (US$0,000335).
O espaço existe. O problema é achar o caso difícil antes de responder.
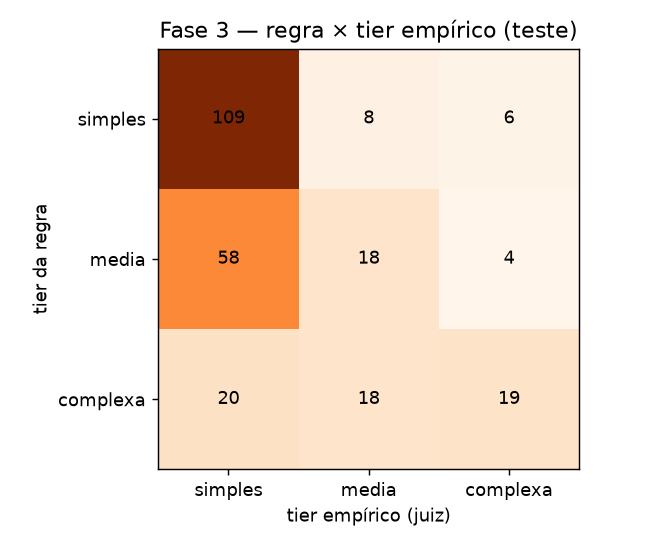
E o que torna um caso difícil? A pista veio da rodada 1 (report/fase3/analise_tier_empirico.md). O rótulo de complexidade concordou com o nível realmente necessário em só 47,9% das mensagens. E apareceu um padrão:
- mensagens sem número de pedido: o barato passou em 93,3%;
- mensagens com número de pedido: o barato passou em só 22,7%.
O que derruba o barato é cruzar os dados do pedido com a política da loja. Foi esse achado que motivou a v2_ctx, que recebe os dados da ferramenta no state. Ela foi a melhor das três, mas não o bastante pra ficar significativamente acima do médio.
E a c0541 mostra o nível seguinte: não basta cruzar dados, às vezes é preciso perceber que o cliente está dizendo algo que os dados contradizem.
O que eu não posso afirmar
- Rótulos sem revisão humana. Templates escritos com apoio de um LLM e rótulos derivados por regra, ainda não revisados.
- Juiz único. Só o DeepSeek V4.1 Flash como LLM-as-judge, sem calibração humana ainda. As notas saturam em 4,75, o que achata diferenças. Pode haver viés a favor de respostas mais longas do modelo caro.
- Dados sintéticos e ferramentas mock. Histórico roteirizado, decisão na última mensagem, sem tool-calling real.
- A vantagem nos casos complexos é exploratória. 57 casos, análise decidida depois de ver os dados.
- Uma localidade. Latência medida de um servidor Linux em São Paulo.
- Sem router gerativo. Não comparei com GPT-6 Luna como router nem com outros decision models.
Como reproduzir
Requer Python 3.11+. O harness usa só a stdlib; os gráficos usam matplotlib.
git clone https://github.com/gabrielcaiana/poc-modelos-de-decisao
cd poc-modelos-de-decisao
python3 -m venv .venv && .venv/bin/pip install matplotlib
cp .env.example .env   # OPENROUTER_API_KEY, exporte no shell

# testes e dry-run, custo zero
python3 -m unittest -v tests.test_poc
python3 -m harness.fase3.run_grid --mock --split calib --limit 20 --out runs/mock-grid

# sem gastar nada: reaproveite o grid gravado
python3 -m harness.fase3.replay runs/fase3-grid          # RESULTADOS_FASE3.md + replay_resultado.json
.venv/bin/python -m harness.fase3.figuras runs/fase3-grid
python3 -m harness.fase3.show runs/fase3-grid c0541     # rastro de uma conversa

# do zero, com API real
python3 datasets/fase3/gerar_conversas.py --n 1000
python3 -m harness.fase3.run_grid --live --split calib --session-cap 1 --out runs/fase3-grid
python3 -m harness.fase3.replay runs/fase3-grid --congelar   # só calib: congela τ1 e a Camada 2
python3 -m harness.fase3.run_grid --live --split teste --session-cap 2 --out runs/fase3-grid
python3 -m harness.fase3.replay runs/fase3-grid
Rodei de novo o replay e o dry-run em mock pra conferir este passo a passo. Os valores de --session-cap no bloco “do zero” são só uma sugestão de teto por execução.
O caminho mais barato pra conferir os números é o do meio: o grid.jsonl está no repo, e o replay não chama API.
O próximo passo
Com o oráculo empírico chegando a 4,706 pelo custo do médio, o caminho é ensinar a Camada 2 a prever o nível empírico, não o rótulo de regra. Antes disso: revisão humana dos rótulos, calibração do juiz com uma planilha cega e um juiz com mais resolução.
Se você tem um chatbot rodando, dá pra testar hoje: pegue algumas centenas de mensagens reais anonimizadas e rode todas no modelo médio e no caro. Onde o médio perde? Se for “quase nunca”, você já tem sua decisão. Se for “nas que cruzam dados com política”, aí um decision model começa a fazer sentido.
O código, os logs e o grid estão em github.com/gabrielcaiana/poc-modelos-de-decisao.
Me segue no LinkedIn e no GitHub pra acompanhar a próxima rodada.